Scene-VLM: Multimodal Video Scene Segmentation via Vision-Language Models, Nimrod Berman et al., 2026 를 읽고 요약, 정리한 글입니다.
Video Scene Segmentation은 긴 영상을 의미적으로 일관된 여러 개의 scene으로 나누는 task이다. 기존 Video Scene Segmentation 방법에서는 주로 각 shot의 visual feature를 추출하고, 해당 shot이 새로운 scene의 시작인지 classifier를 통해 판단했다.
하지만 Scene을 구분하기 위해서는 단순한 visual 변화뿐만 아니라
- 장소
- 시간
- 등장인물
- 대화
- 이야기의 흐름
등 다양한 정보를 함께 이해해야 한다.
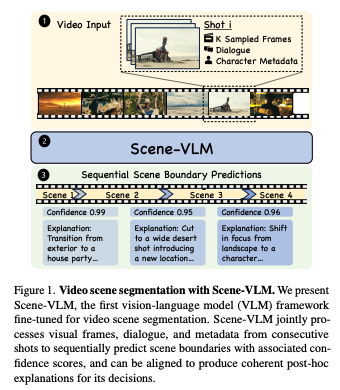
본 논문에서는 기존 encoder 기반 방법 대신 Vision-Language Model(VLM) 을 이용해 여러 개의 shot을 multimodal하게 이해하고 scene boundary를 sequential하게 생성하는 Scene-VLM을 제안한다.
Scene-VLM은 각 shot의
- Visual Frame
- Dialogue
- Character Metadata
를 함께 입력받으며, scene boundary뿐만 아니라 confidence score와 자연어 explanation까지 생성할 수 있다.
◾️ Abstract
Video Scene Segmentation은 long-form video를 의미적으로 일관된 여러 scene으로 나누는 task이다. 기존 encoder 기반 scene segmentation 방법에는 크게 세 가지 한계가 있다.
첫 번째는 visual-centric bias이다. 많은 기존 방법들이 visual information을 중심으로 scene boundary를 판단하기 때문에,
- 대화 내용
- 등장인물
- narrative context
와 같은 non-visual information을 충분히 활용하지 못한다.
두 번째는 point-wise prediction이다. 기존 방법들은 여러 shot의 관계를 고려하면서 순차적으로 scene boundary를 판단하기보다 각각의 shot을 독립적인 binary classification 문제로 처리하는 경우가 많다.
세 번째는 explainability가 부족하다. 기존 classifier에서는 Scene Boundary Probability = 0.92 와 같은 confidence score는 얻을 수 있지만, 왜 이 지점을 새로운 Scene으로 판단했는가? 에 대한 설명을 제공하기 어렵다.
본 논문에서는 이를 해결하기 위해 Scene-VLM을 제안한다.
Scene-VLM은 consecutive shots의 visual frame, dialogue, character metadata를 함께 입력받고 VLM을 이용하여 scene boundary를 sequential하게 예측한다.
또한,
- Structured Multimodal Shot Representation
- Sequential Prediction
- Context-Focus Window
- Token Logit 기반 Confidence Score
- Natural Language Explanation
등을 함께 제안한다.
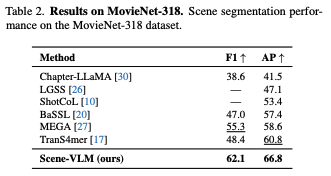
MovieNet-318에서 Scene-VLM은 기존 방법 대비 높은 성능을 기록했으며, TranS4mer와 비교했을 때 +6.0 AP, +13.7 F1의 성능 향상을 보였다.
◾️ Introduction
Scene-VLM을 이해하기 전에 먼저 Shot과 Scene의 차이를 이해할 필요가 있다.
Shot
Shot은 camera가 끊기지 않고 연속적으로 촬영된 frame의 집합이다.
Camera Start
      ↓

Frame
Frame
Frame
Frame

      ↓
Camera Cut
즉 하나의 continuous camera take를 하나의 shot이라고 볼 수 있다.
Scene
Scene은 하나 이상의 shot이 모여
- Location
- Time
- Characters
- Narrative Theme
등에서 의미적으로 하나의 일관된 구간을 이루는 것이다.
예를 들어 영화에서 두 사람이 대화하는 장면을 생각해보자.
Shot 1 : Person A
Shot 2 : Person B
Shot 3 : Person A
Shot 4 : 두 사람이 함께 등장
camera angle은 계속 변경되기 때문에 각각은 서로 다른 shot이다.
하지만 모두 같은 장소에서 동일한 두 사람이 같은 대화를 이어가고 있기 때문에
Shot 1
Shot 2
Shot 3
Shot 4
   ↓
Scene 1
이라고 볼 수 있다.
이후 갑자기 "Shot 5 : 다음날 자동차를 운전하는 장면"으로 변경된다면,
Shot 4
────── Scene Boundary ──────
Shot 5
와 같이 Shot 4와 Shot 5 사이를 Scene Boundary로 판단할 수 있다.
즉 Scene Segmentation은 단순히 camera cut을 찾는 문제가 아니다.
Visual Change

+

Temporal Context

+

Character

+

Dialogue

+

Narrative Flow
등을 종합적으로 이해해야 한다.
◾️ 기존 Scene Segmentation의 한계
기존 Scene Segmentation에서는 일반적으로
Shot
 ↓
Visual Feature Extraction
 ↓
Temporal Encoder
 ↓
Boundary Classifier
 ↓
Boundary / Non-Boundary
형태의 접근을 사용한다.
대표적으로
- ShotCoL
- BaSSL
- TranS4mer
- MEGA
등이 있다.
BaSSL은 pseudo-boundary를 이용한 self-supervised learning을 사용하며, TranS4mer는 self-attention과 state-space layer를 결합하여 long-range dependency를 modeling한다. MEGA는 video, audio, text feature를 multimodal하게 결합한다. 하지만 저자들은 기존 접근에 공통적으로 몇 가지 한계가 있다고 이야기한다.
1. Visual-Centric Bias
첫 번째는 visual information에 지나치게 의존한다는 점이다. Scene이 바뀌는 것은 항상 visual appearance가 크게 변하는 경우만 있는 것은 아니다.
예를 들어 동일한 장소에서 같은 등장인물이 대화를 하고 있다고 해보자.
A와 B가 현재 회사에 대해 대화
        ↓
A와 B가 과거 사건에 대해 이야기
visual appearance는 거의 동일할 수 있다. 하지만 narrative context는 크게 달라질 수 있다.
반대로 빠르게 camera cut이 발생한다고 해서 항상 새로운 scene이 시작되는 것도 아니다. 따라서 Scene Segmentation에서는
Visual
+
Dialogue
+
Character
+
Temporal Context
를 함께 고려하는 것이 중요하다.
2. Point-wise Prediction
두 번째는 기존 모델들이 대부분 각각의 shot을 독립적으로 판단한다는 것이다.
예를 들어,
Shot 1 → No
Shot 2 → No
Shot 3 → Yes
Shot 4 → No
Shot 5 → No
와 같이 각각의 shot에 대해 boundary 여부를 예측한다. 하지만 Scene Segmentation은 본질적으로 sequential한 문제이다. 예를 들어 모델이 이미 "Shot 3 → Scene Boundary"라고 판단했다면 Shot 4를 판단할 때 "Shot 3에서 새로운 Scene이 시작되었다."라는 정보가 도움이 될 수 있다.
Scene-VLM에서는 이를 활용하기 위해 여러 shot의 prediction을 하나의 output sequence로 생성한다.
3. Explainability
기존 classifier에서는 confidence score는 얻을 수 있다. 예를 들어, "Boundary Probability = 0.94"와 같이 표현할 수 있다.
하지만 왜 해당 지점을 Scene Boundary로 판단했는지는 알기 어렵다.
VLM을 사용하면
장소가 실내에서 야외로 변경되었으며,
등장인물과 대화 주제가 모두 변경되었기 때문에
새로운 Scene으로 판단하였다.
처럼 자연어 rationale을 생성할 수 있다.
이 부분이 Scene-VLM에서 VLM을 사용하는 중요한 이유 중 하나이다.
◾️ Scene-VLM
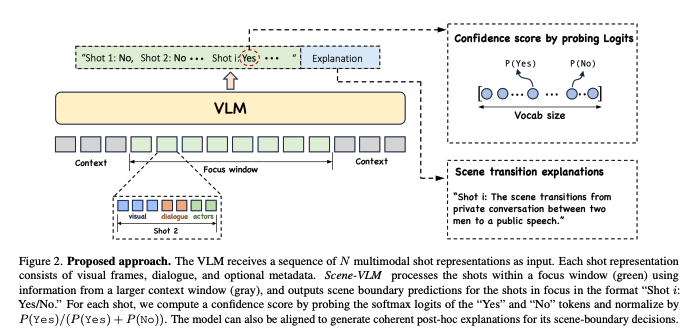
Scene-VLM의 전체 구조는 다음과 같다.
                     ┌─ Visual Frames
Shot 1 ──────────────┼─ Dialogue
                     └─ Actor Metadata

                     ┌─ Visual Frames
Shot 2 ──────────────┼─ Dialogue
                     └─ Actor Metadata

                     ...

                     ┌─ Visual Frames
Shot N ──────────────┼─ Dialogue
                     └─ Actor Metadata

                       ↓

              Vision-Language Model

                       ↓

Shot 1 : No
Shot 2 : No
Shot 3 : Yes
Shot 4 : No
Shot 5 : Yes
...
논문에서는 base model로 Qwen2.5-VL-7B를 사용한다.
Scene-VLM의 핵심 아이디어는 크게 다음과 같이 정리할 수 있다.
1. Multimodal Shot Representation

2. Sequential Prediction

3. Context-Focus Window

4. Confidence Score from Token Logits

5. Natural Language Explanation
◾️ Multimodal Shot Representation
연속된 (N)개의 shot을 하나의 context라고 정의한다. 각 shot (s_i)에는 여러 visual frame과 dialogue, actor metadata가 들어간다.
대략 다음과 같이 생각할 수 있다.
Shot i

├─ Frame 1
├─ Frame 2
├─ Frame 3
│
├─ Dialogue
│   "Where are you going?"
│
└─ Actor Metadata
    Person A, Person B
논문의 기본 설정에서는 하나의 shot마다 3개의 frame을 sample한다. 그리고 모든 shot 정보를 instruction prompt와 함께 VLM에 전달한다.
즉 기존 방법처럼 미리 visual feature만 추출하는 것이 아니라,
Raw Visual Frame
+
Dialogue
+
Actor Information
을 직접 VLM이 함께 처리한다.
◾️ Shot-ID Marker
Scene-VLM에서 재미있는 방법 중 하나이다. 논문에서는 각 visual frame의 왼쪽 위에 해당 frame이 어느 shot인지 알 수 있도록 Shot-ID를 직접 표시한다.
예를 들어,
┌────────────────────┐
│  7                 │
│                    │
│       Frame        │
│                    │
└────────────────────┘
와 같은 방식이다. 왜 굳이 image 자체에 숫자를 추가했을까?
VLM에 여러 장의 image를 동시에 입력하면 "어떤 Frame이 어떤 Shot과 연결되는가?"가 모호해질 수 있기 때문이다.
따라서
Visual Frame
      ↕
   Shot-ID
      ↕
Textual Shot Representation
의 correspondence를 명시적으로 만들어준다. 이 방법은 상당히 단순하지만 실제 성능에도 영향을 준다.
Shot-ID를 제거하면 F1이 62.1에서 60.8로 감소한다.
개인적으로 VLM을 여러 image와 함께 사용하는 task에서 꽤 실용적으로 활용할 수 있는 방법이라고 생각한다.
◾️ Sequential Prediction
Scene-VLM의 핵심적인 특징 중 하나이다.
기존 방법은 다음과 같이 각각의 shot을 독립적으로 판단하는 경우가 많다.
Shot 1 → Classifier → No

Shot 2 → Classifier → No

Shot 3 → Classifier → Yes
반면 Scene-VLM은 다음과 같은 하나의 text sequence를 생성한다.
Shot 5: No
Shot 6: No
Shot 7: Yes
Shot 8: No
Shot 9: No
Shot 10: Yes
VLM은 autoregressive model이기 때문에 Shot 8을 생성할 때 이미
Shot 5: No
Shot 6: No
Shot 7: Yes
라는 이전 output을 알고 있다.
즉 현재 shot의 prediction이 다음 shot의 prediction에 영향을 준다.
Shot 5 → No
       ↓
Shot 6 → No
       ↓
Shot 7 → Yes
       ↓
새로운 Scene 시작
       ↓
Shot 8 → No
기존 point-wise prediction과 비교하면
Point-wise

Shot 1 ──→ Prediction
Shot 2 ──→ Prediction
Shot 3 ──→ Prediction
에서
Sequential

Shot 1
   ↓
Prediction 1
   ↓
Shot 2
   ↓
Prediction 2
   ↓
Shot 3
   ↓
Prediction 3
와 같은 구조로 변경된 것이다.
◾️ Context-Focus Window
Scene-VLM에서 가장 중요한 design 중 하나이다. 예를 들어 VLM에 10개의 shot을 입력하고 모든 shot을 판단한다고 해보자.
Shot 1 Shot 2 Shot 3 ... Shot 9 Shot 10
  ↑                                  ↑
Past Context 부족            Future Context 부족
첫 번째 shot은 이전 context가 부족하고, 마지막 shot은 이후 context가 부족하다. 이러한 문제를 Edge Effect라고 볼 수 있다.
Scene boundary를 정확하게 판단하려면 해당 shot 이전뿐만 아니라 이후의 영상도 함께 보는 것이 중요하다. Scene-VLM에서는 이를 해결하기 위해 Context Window와 Focus Window를 분리한다.
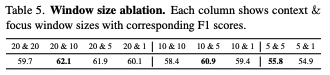
논문의 기본 설정은 Context Window = 20 Shots, Focus Window = 10 Shots 이다.
구조를 단순화하면 다음과 같다.
                Context Window

────────────────────────────────────────────

1  2  3  4  5 | 6  7  8  9  10  11  12  13  14  15 | 16 17 18 19 20
                └──────── Focus Window ────────┘
VLM은 20개 shot 전체를 볼 수 있지만 실제 boundary prediction은 가운데 10개 shot에 대해서만 수행한다.
따라서 Focus Window에 위치한 shot들은 항상
Past Context

+

Future Context
를 충분히 확보할 수 있다.
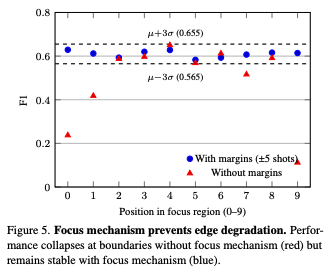
Context-Focus Window가 실제로 필요한가?
논문에서는 Focus mechanism을 제거한 경우와 사용한 경우를 비교한다.
Focus mechanism을 사용하지 않으면 sequence 양 끝에 위치한 shot에서 F1이 크게 감소한다.
Without Context Margin

Shot Position

0  1  2  3  4  5  6  7  8  9
↓                             ↓

성능 크게 감소          성능 크게 감소
반면 앞뒤에 ±5개의 shot context를 제공하면 shot의 위치와 관계없이 비교적 일정한 F1을 유지한다.
즉 중요한 것은 단순히 "많은 Shot을 VLM에 입력한다." 가 아니다. 보다 정확하게는 판단하려는 Shot의 앞뒤로 충분한 temporal context를 확보하는 것이 중요하다.
◾️ Computing Confidence Score
일반적인 binary classifier에서는 다음과 같이 probability를 계산할 수 있다.
probability = sigmoid(logit)
하지만 Scene-VLM은 generative VLM이다. 모델의 output은 "Shot 7: Yes"와 같은 text token이다.
따라서 별도의 scene-boundary classification head가 존재하지 않는다. 그러면 confidence score는 어떻게 얻을 수 있을까?
Scene-VLM에서는 Yes와 No token의 logit을 이용한다. VLM이 특정 위치에서 다음 token을 생성할 probability를 생각해보자. Vocabulary 전체에 대해 softmax probability가 계산된다. 그중 Yes, No 두 token의 probability를 가져온다. 그리고 다시 normalize한다.
즉 vocabulary 전체에 대한 Yes probability를 그대로 사용하는 것이 아니라, Yes vs No 두 후보 사이에서 다시 normalize한다.이렇게 하면 generative VLM을 사용하면서도 기존 classifier처럼 Confidence > Threshold 형태의 system을 만들 수 있다.
Confidence Score가 중요한 이유
실제 서비스에서는 사용 목적에 따라 threshold를 조절해야 하는 경우가 많다.
예를 들어,
Threshold ↓
Recall ↑
Precision ↓반대로
Threshold ↑
Precision ↑
Recall ↓가 된다.
Scene Boundary를 최대한 많이 찾는 것이 중요하다면 threshold를 낮출 수 있고, 확실한 boundary만 필요한 경우에는 threshold를 높일 수 있다.
즉 generative VLM에 기존 binary classifier의 장점인 Precision-Recall Control을 추가한 것이다.
◾️ Training
Scene-VLM의 base model은 Qwen2.5-VL-7B 이다.
모델은 Focus Window에 포함된 shot에 대해
Shot 5: No
Shot 6: Yes
Shot 7: No
...
형태의 output을 생성하도록 fine-tuning한다. 학습 자체는 일반적인 autoregressive language model과 동일하게 next-token prediction을 이용한다.
주요 설정은 다음과 같다.
Base Model      : Qwen2.5-VL-7B

Context Window  : 20 Shots

Focus Window    : 10 Shots

Frames per Shot : 3

Training Samples: 약 29K

Fine-tuning     : LoRA

LoRA Rank       : 8

LoRA Alpha      : 16

Epoch           : 4

GPU             : 8 × A100 40GB
즉 7B VLM 전체를 처음부터 학습한 것이 아니라 pretrained VLM을 기반으로 LoRA fine-tuning을 수행한다.
◾️ Dataset
MovieNet-318
Scene-VLM의 주요 training 및 evaluation dataset이다. MovieNet-318은 총 318개의 movie로 구성되어 있다.
Train      : 190

Validation : 64

Test : 64각 movie에는 평균 약 1,000개의 shot이 존재하며 각각의 shot에 scene boundary annotation이 포함되어 있다.
BBC Planet Earth
Domain Generalization을 평가하기 위해 사용한다. BBC Planet Earth는 MovieNet과 상당히 다른 형태의 영상이다.
MovieNet

영화
대화 중심
Cinematic Editing
Actor 중심
반면,
BBC Planet Earth

자연 다큐멘터리
Narration
Landscape
Wildlife
와 같은 차이가 있다.
논문에서는 MovieNet으로 학습한 Scene-VLM을 BBC Planet Earth에 별도의 추가 학습 없이 Zero-Shot Evaluation한다. 이를 통해 Scene-VLM이 학습 domain과 다른 종류의 영상에도 generalization할 수 있는지 확인한다.
◾️ Experimental Results
MovieNet-318
MovieNet-318에서의 결과는 다음과 같다.
Method             F1      AP

Chapter-LLaMA     38.6    41.5
LGSS               -      47.1
ShotCoL            -      53.4
BaSSL             47.0    57.4
MEGA              55.3    58.6
TranS4mer         48.4    60.8

Scene-VLM         62.1    66.8
Scene-VLM이 F1과 AP 모두 가장 높은 성능을 기록한다.
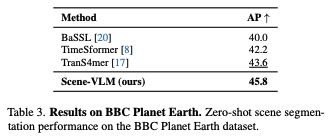
Zero-Shot on BBC Planet Earth
MovieNet에서 학습한 Scene-VLM을 BBC Planet Earth에 그대로 적용한 결과이다.
Method          AP

BaSSL          40.0
TimeSformer    42.2
TranS4mer      43.6

Scene-VLM      45.8
Scene-VLM은 기존 최고 성능인 TranS4mer보다 +2.2AP 높은 성능을 보인다.
Movie와 자연 다큐멘터리는 visual style과 narrative structure가 크게 다르기 때문에 의미 있는 결과라고 볼 수 있다. Pretrained VLM이 가지고 있는 multimodal representation과 semantic understanding이 cross-domain generalization에도 도움이 된 것으로 보인다.
◾️ Attention Analysis
논문에서는 Scene-VLM이 실제로 어떤 정보를 이용해 Scene Boundary를 판단하는지도 분석한다.
Scene-VLM의 input에는 Visual, Subtitle, Actor ID가 존재한다.
그리고 autoregressive generation을 사용하기 때문에 이전에 생성한
Shot 5: No
Shot 6: Yes
...
와 같은 output token도 존재한다. 논문에서는 각 modality에 대한 attention 값을 분석한다.
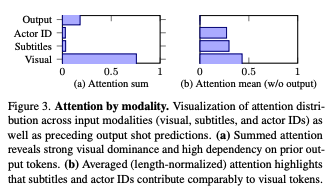
전체 attention을 단순하게 더하면 Visual Token이 가장 큰 비중을 차지한다. 또한 이전에 생성된 output token도 상당히 높은 attention을 받는다.
즉, Visual Information+ Previous Boundary Prediction이 Scene-VLM의 현재 boundary decision에서 중요한 역할을 한다.
하지만 한 가지 고려해야 할 부분이 있다. Visual token은 subtitle이나 actor metadata보다 token 개수가 훨씬 많다. 따라서 attention의 합만 비교하면 visual이 크게 나타나는 것은 어느 정도 당연할 수 있다.
논문에서는 이를 보정하기 위해 각 modality의 token 수로 나눈 평균 attention도 계산한다. 그 결과, Visual, Subtitle, Actor ID 모두 상당한 attention을 받는다.
즉 visual이 가장 중요한 modality이기는 하지만 subtitle과 actor information 역시 scene transition 판단에 유용하게 사용되고 있음을 알 수 있다.
◾️ Temporal Attention
논문에서는 현재 prediction이 input sequence의 어느 shot에 attention하는지도 분석한다.

흥미로운 점은 현재 shot보다 이후에 등장하는 shot에 더 많은 attention을 주는 경우가 많다는 것이다.
예를 들어 Shot 11을 판단한다고 해보자. Scene-VLM은 이미 이전 output으로
Shot 6: No
Shot 7: Yes
Shot 8: No
Shot 9: No
Shot 10: No
를 생성했다.
따라서 이전 shot에 대한 정보는 어느 정도 이전 prediction token에 반영되어 있다. 반면 Shot 11이 실제 Scene Boundary인지 확실하게 확인하기 위해서는
Shot 12
Shot 13
Shot 14
...
와 같은 미래 context가 중요해진다.
즉,
Past Information
      ↓
Previous Prediction Token에 일부 반영

Future Information
      ↓
Input Shot을 직접 Attention
하는 형태로 볼 수 있다.
이 결과는 앞에서 설명한 Sequential Prediction과 Context-Focus Window가 중요한 이유와도 연결된다.
◾️ Sequential Prediction은 실제로 효과가 있는가?
Scene-VLM에서는 여러 shot을 하나의 sequence에서 sequential하게 prediction하는 것이 중요하다고 주장한다. 이를 확인하기 위해 Focus Window의 크기를 변경한다.
Context / Focus     F1

20 / 20            59.7

20 / 10            62.1

20 / 5             61.9

20 / 1             60.1

10 / 10            58.4

10 / 5             60.9

10 / 1             59.4

5 / 5              55.8

5 / 1              54.9
가장 좋은 결과는 Context = 20, Focus = 10에서 나온다. 또 같은 Context Window를 사용해도 Focus Window를 1로 줄이면 성능이 감소한다.
Focus가 1이라는 것은 사실상 매번 하나의 prediction만 생성하기 때문에 point-wise prediction에 가까워진다. 따라서 여러 shot의 결과를 autoregressive하게 생성하는 Sequential Prediction이 실제 성능 향상에 도움이 된다는 것을 확인할 수 있다.
또한 전체적으로 Context Window가 길어질수록 성능이 좋아진다.
Longer Temporal Context
          ↓
Scene Boundary Disambiguation에 도움
을 주는 것이다.
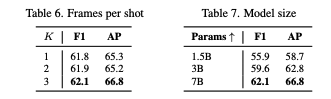
◾️ Number of Frames per Shot
하나의 shot에서 몇 개의 frame을 사용해야 하는지도 실험한다.
Frames per Shot     F1     AP

1                  61.8   65.3

2                  61.9   65.2

3                  62.1   66.8
3개의 frame을 사용하는 것이 가장 좋은 결과를 보인다. 하지만 개인적으로 더 흥미로운 부분은 1개의 frame을 사용해도 성능 차이가 매우 작다는 점이다.
1 Frame

F1 = 61.8

3 Frames

F1 = 62.1
차이는 0.3 point에 불과하다. 일반적으로 하나의 shot 내부에서는 큰 scene-level visual change가 발생하지 않는다.
따라서 한 장의 representative frame만으로도 해당 shot의 visual information을 상당 부분 표현할 수 있는 것으로 보인다. 이는 실제 inference cost 측면에서 상당히 중요한 결과이다.
VLM에서 visual token은 많은 연산량을 차지하기 때문이다.
3 Frames / Shot

↓

1 Frame / Shot

↓

Visual Token 크게 감소

↓

Inference Cost 감소
하면서 성능은 상당 부분 유지할 수 있다.
◾️ Model Size
Qwen2.5-VL의 model size에 따른 결과는 다음과 같다.
Model Size     F1     AP

1.5B          55.9   58.7

3B            59.6   62.8

7B            62.1   66.8
model size가 커질수록 성능 역시 지속적으로 증가한다.
1.5B
 ↓
3B
 ↓
7B

Scene Segmentation Performance ↑
특히 7B에서도 scaling에 따른 성능 향상이 이어지고 있기 때문에 더 큰 VLM을 사용할 경우 추가적인 improvement가 있을 가능성이 있다. 다만 본 논문에서는 7B보다 큰 model을 직접 실험하지는 않았다.
◾️ Adaptation to Video Chaptering
Scene-VLM의 또 다른 특징은 Scene Segmentation뿐 아니라 Video Chaptering task에도 쉽게 적용할 수 있다는 점이다.
Scene Segmentation에서는
Shot 10: Yes
와 같이 boundary 여부만 생성한다. 반면 Video Chaptering에서는
00:03:24 - Introduction

00:08:45 - Training Method

00:17:30 - Experimental Results
처럼 boundary timestamp와 chapter title을 함께 생성해야 한다. Scene-VLM에서는 architecture를 크게 변경하지 않고 output format만 변경한다.
Scene Segmentation

Shot 10: Yes
에서
Video Chaptering

00:03:24 - Introduction
형태로 변경하는 것이다.
◾️ Post-hoc Explainability
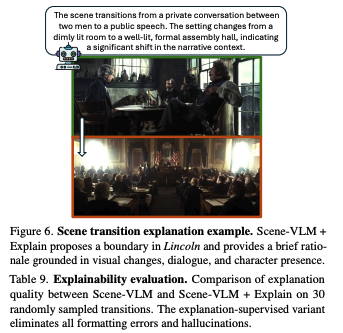
Scene-VLM이 기존 encoder 기반 Scene Segmentation과 가장 크게 다른 부분 중 하나이다. Scene Boundary뿐만 아니라 "왜 해당 Shot이 Scene Boundary인가?" 에 대한 자연어 explanation을 생성할 수 있다.
예를 들어,
The scene transitions from a private conversation
between two men to a public speech.

The setting changes from a dimly lit room
to a well-lit formal assembly hall.
와 같이 설명할 수 있다.
즉 prediction 결과를 Shot 15: Yes 에서 끝내지 않고,
Shot 15: Yes

Reason:
장소와 이야기의 중심이 크게 변경되었다.
형태로 확장할 수 있다.
◾️ 단순 Prompting만으로 Explanation을 생성하면?
VLM이 이미 language generation 능력을 가지고 있기 때문에 "왜 이 Scene을 Boundary라고 판단했는지 설명해줘." 라고 prompt만 변경하면 충분할 것 같지만 실제로는 그렇지 않았다.
Scene Boundary detection만 fine-tuning한 기본 Scene-VLM에 explanation을 요청하면
- Formatting Error
- Hallucination
이 자주 발생했다.
즉 VLM이 원래 가지고 있는 generation 능력만으로는 Scene Boundary 판단에 grounded된 explanation을 안정적으로 생성하지 못했다.
◾️ Alignment via Minimal Supervision
이를 해결하기 위해 저자들은 explanation에 대한 추가 supervision을 사용한다. 그런데 annotation의 개수가 상당히 적다.
단 35개의 human-annotated explanation만 사용한다. 각 sample에는
Scene Boundary

+

왜 Scene이 변경되었는지에 대한 설명
이 포함된다.
예를 들어,
Location Change

Time Change

Character Change

Dialogue Topic Change
등을 설명한다. 이 35개의 sample로 추가 fine-tuning한 모델을 Scene-VLM + Explain 이라고 한다.
◾️ Scene-VLM을 기존 방법과 비교하면
지금까지 내용을 정리하면 다음과 같다.
기존 Scene Segmentation

Video
 ↓
Shot
 ↓
Visual Feature Extraction
 ↓
Encoder
 ↓
Binary Boundary Classifier
Scene-VLM은 이를 다음과 같이 변경한다.
Long-form Video
        ↓
      Shots
        ↓
┌──────────────────────┐
│ Visual Frames        │
│ Dialogue             │
│ Character Metadata   │
└──────────────────────┘
        ↓
20-Shot Context Window
        ↓
10-Shot Focus Window
        ↓
Qwen2.5-VL
        ↓
Sequential Prediction
        ↓
Shot 5: No
Shot 6: No
Shot 7: Yes
Shot 8: No
        ↓
Yes / No Token Logit
        ↓
Confidence Score

        +

Natural Language Explanation
핵심적인 차이를 표로 정리하면 다음과 같다.
                   기존 Encoder 방식       Scene-VLM

Model              Encoder + Classifier      VLM

Visual             O                         O

Dialogue           일부 모델                O

Character          일부 모델                O

Prediction         Point-wise                Sequential

Temporal Context   Local Window              Context-Focus Window

Confidence         Classifier Probability    Yes/No Token Logit

Explanation        어려움                    Natural Language

Task Adaptation    별도 구조                 Output Format 변경
◾️ Limitation
논문에서는 Scene-VLM의 한계도 언급한다.
1. Structured Output
현재 Scene-VLM은
Shot 1: Yes

Shot 2: No
와 같이 매우 rigid한 output format을 사용한다.
이러한 구조는 Yes와 No token logit을 정확하게 찾을 수 있다는 장점이 있다.
Structured Output
        ↓
Yes / No Token 위치를 쉽게 찾을 수 있음
        ↓
Confidence Score 계산 가능
하지만 반대로 VLM이 가지고 있는 자유로운 generation ability는 제한된다. 즉,
Reliable Structured Output
              ↑

Generative Flexibility
              ↓
라는 trade-off가 존재한다. 저자들은 future work에서 보다 flexible한 output format이나 reinforcement learning 기반 reasoning을 연구할 수 있다고 언급한다.
2. Computational Cost
개인적으로 실제 적용 측면에서는 computational cost도 중요한 한계라고 생각한다. 기존 TranS4mer와 같은 encoder 기반 모델과 비교하면 Scene-VLM은 7B VLM이다. 기본 설정에서는 한 context에
20 Shots

×

3 Frames per Shot

=

60 Frames
이 들어간다. 여기에 subtitle과 metadata token까지 추가된다. 따라서 기존 Scene Segmentation model보다 inference cost와 memory 사용량이 훨씬 크다.
Appendix의 computational analysis에서도 encoder 기반 TranS4mer가 latency와 memory 측면에서는 훨씬 효율적이다. 즉 Scene-VLM은 Accuracy, Explainability, Multimodal Reasoning ↑ 을 얻는 대신, Inference Cost, Memory ↑ 라는 trade-off를 가지고 있다.
3. Actor Metadata Availability
MovieNet에서는 actor identity metadata를 사용할 수 있다. 하지만 실제 arbitrary video에서는 항상 Actor ID가 존재한다고 보장할 수 없다.
실제 production 환경에서는
Visual

+

ASR Transcript
정도만 사용할 가능성이 높다.
다행히 ablation을 보면 Actor-ID를 제거해도 F1 62.1 → 61.3 정도로 성능 감소가 크지 않다. 따라서 Scene-VLM이 Actor Metadata에 지나치게 의존하는 것은 아닌 것으로 보인다.
4. Long-term Narrative Understanding
Context Window가 20개의 shot이기 때문에 전체 영화의 narrative를 한 번에 이해하는 것은 아니다. 실제 영화에는 수천 개의 shot이 존재할 수 있다. 따라서 Scene-VLM은 대략
20-Shot Context
        ↓
Prediction
        ↓
Window 이동
        ↓
20-Shot Context
        ↓
Prediction
형태로 처리하게 된다.
즉 pretrained VLM을 사용한다고 해서 영화 전체의 장기적인 narrative state를 계속 기억하는 것은 아니다.
향후에는
- Long-Context VLM
- Hierarchical Video Representation
- External Memory
- Scene-level Memory
등을 결합하면 더 긴 temporal dependency를 이용할 수 있을 것으로 생각한다.
◾️ Conclusion
본 논문에서는 Vision-Language Model을 Video Scene Segmentation에 적용한 Scene-VLM을 제안한다.
기존 Scene Segmentation에서는 일반적으로
Shot
 ↓
Encoder
 ↓
Boundary Classification
형태의 discriminative approach를 사용했다.
Scene-VLM에서는 이를
Multiple Shots
      ↓
Visual + Dialogue + Metadata
      ↓
Vision-Language Model
      ↓
Sequential Boundary Generation
문제로 변경한다.
Scene-VLM의 핵심 아이디어를 다시 정리하면 다음과 같다.
1. Multimodal Shot Representation : Visual + Dialogue + Character Metadata 를 함께 사용한다.
2. Sequential Prediction : 각각의 Shot을 독립적으로 판단하지 않고 여러 boundary prediction을 하나의 autoregressive sequence로 생성한다.
3. Context-Focus Window : 판단해야 하는 Focus Shot 앞뒤에 충분한 temporal context를 제공한다.
4. Confidence from Token Logits : Generative VLM에 별도의 classifier head를 추가하지 않고 Yes vs No token logit을 이용해 confidence score를 계산한다.
5. Natural Language Explanation : VLM의 language generation 능력을 이용하여 Scene Boundary가 발생한 이유까지 자연어로 설명한다.
결과적으로 Scene-VLM은 MovieNet-318에서 F1 = 62.1, AP = 66.8을 기록하며 기존 Scene Segmentation 방법보다 높은 성능을 보였다.
또한 MovieNet에서 학습한 모델을 BBC Planet Earth에 Zero-Shot으로 적용했을 때도 기존 방법보다 높은 성능을 보였다. 개인적으로 이 논문에서 가장 흥미로웠던 부분은 단순히 "기존 Encoder 대신 VLM을 사용했다."는 점은 아니었다.
오히려 기존 binary classification task를 generative VLM에 어떻게 자연스럽게 옮길 것인가에 대한 engineering design이 재미있었다.
예를 들어,
Generative VLM은
Classifier처럼 Confidence Score가 없는데?

        ↓

Yes / No Token Logit을 사용하자.
라는 방법이나,
Sequence 양쪽 끝은
Temporal Context가 부족한데?

        ↓

Context와 Focus Window를 분리하자.
라는 방법,
또는
여러 Image를 동시에 입력하면
어떤 Frame이 어떤 Shot인지 헷갈리지 않을까?

        ↓

Frame 자체에 Shot-ID를 표시하자.
와 같은 아이디어이다.
새로운 복잡한 architecture를 처음부터 제안하기보다는 기존 pretrained VLM이 가지고 있는
Visual Understanding

+

Language Understanding

+

Multimodal Reasoning

+

Text Generation
능력을 Scene Segmentation이라는 task에 맞게 잘 구조화했다는 점에서 실용적인 논문이라고 생각한다.
특히 기존에는 Scene Boundary Detection=Binary Classification 문제로 생각했던 것을
Video Scene Segmentation
        ↓
Multimodal Sequence Understanding
        ↓
Structured Language Generation
문제로 다시 정의했다는 점이 가장 중요한 부분인 것 같다.
최근 VLM이 VQA나 Image Captioning을 넘어 기존 Computer Vision task에도 적극적으로 적용되고 있는데, 기존 discriminative task를 VLM의 structured generation task로 어떻게 변환할 수 있는지 보여주는 좋은 사례라고 생각한다.